WorkBuddy 里这一长串模型,到底该点哪个?
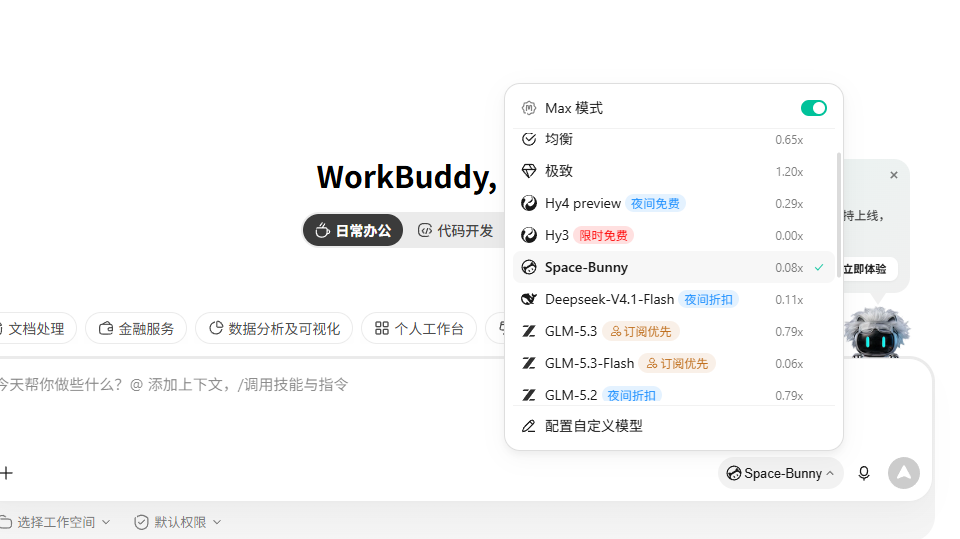
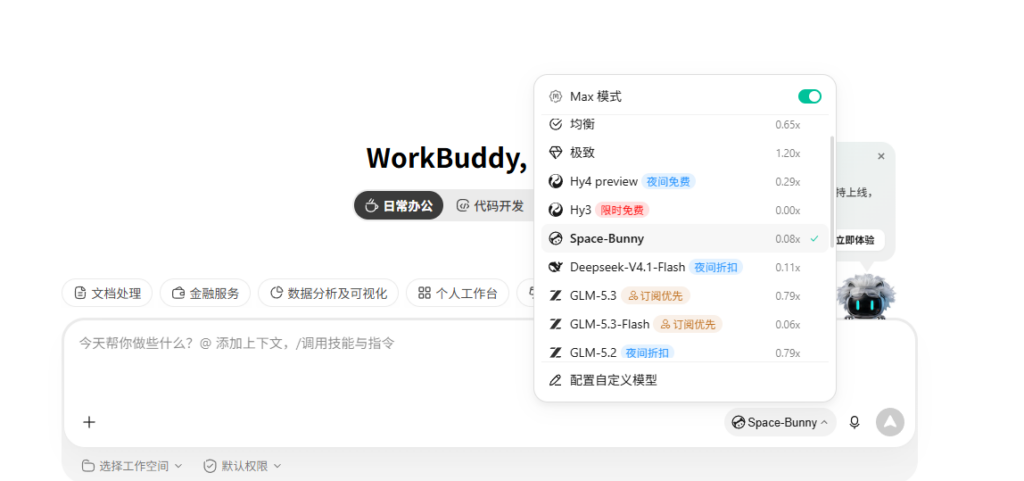
第一次把模型列表拉到底,我盯着那串名字看了半天——HY、GLM、MiniMax、Kimi、DeepSeek,每个后面还挂个小数点,0.05、0.79、1.62 参差不齐。第一反应真不是”选择真多”,是懵。随便点一个吧,怕白烧积分;挨个研究吧,光把名字记全就得搭进去一下午。
后来踩了几次坑才慢慢摸明白:这些模型压根不是谁替代谁的关系,是各干各的活儿。挑对了又省又出活,挑错了要么慢、要么贵,出来的东西还不一定对路。今天就把它们挨个拆开说清楚:分别是谁家的、适合干什么、哪个更强、哪个更省。
列表一拉到底,第一反应确实是懵
先搞懂后面那个小数点
模型名字后面挂的数字叫倍率,代表积分消耗,数字越低越便宜,倍率是 0 就是免费。这里有个坑我得先说清楚:倍率高不等于能力强。它只说明这个模型更贵、更吃资源,不代表它干的活一定更适合你。很多人下意识觉得”贵的一定好”,在模型选型这件事上,这个直觉经常是错的。
混元 HY 系列:腾讯自己那个”稳”字派
HY 就是腾讯自研的混元,已经用在腾讯自己一堆产品和业务里了,属于国内大厂自研模型的代表。它给我的整体感觉是稳,不激进,但不容易翻车。
它家里两个型号值得记。HY 4 preview 适合处理长资料和步骤特别多的任务——比如一次读完七八份报告再帮你整理结论,或者查资料写成一份完整方案,再或者一个任务需要连续改十几轮。倍率 0.29,现在有限时免费入口。
另一个是更便宜的日常款(就是大家常说的 H3),倍率只有 0.05。写通知、周报、会议纪要、整理资料、总结文章这些普通办公活儿,优先选它。说白了,你只是写段文案或者做个简单总结,真没必要上 preview,杀鸡用牛刀还贵。
我自己的划分:0.05 那档干日常,0.29 那档干硬仗。大部分时候,日常就够了。
智谱 GLM 系列:清华底子,性价比藏在这儿
GLM 来自智谱,智谱源自清华的技术成果,也是国内较早一批做通用大模型的公司,ChatGLM 在行业里知名度一直挺高。
GLM 5.3 是这一家的高配版,主攻复杂分析、编程和需要长时间连续执行的任务。开发一个网站、排查复杂的程序问题、做一份步骤特别多的深度研究,可以考虑它。但倍率是 0.79,普通文案和简单办公没必要上。
真正让我觉得香的是 GLM 5.3 flash,倍率只有 0.06。它能看产品截图、表格、图表、网页和视频,也能写文案做总结。对普通用户来说,这个型号比 5.3 实用得多。你要是任务里既有图片又有文字,想兼顾效果和积分,优先选它准没错。
顺带提两句容易踩的坑。GLM 5.2 和 5.1 是前两代,倍率也都是 0.79,能力不算差,但价格一点优势没有——新手没有明确需求,别优先选旧型号。GLM 5v turbo 也能看图片、视频和文字,更偏视觉材料分析,倍率 0.71。我的建议是:普通看图看视频先用 5.3 flash,结果不理想再考虑它。
MiniMax M3:啥都能接一把的全能选手
M3 来自 MiniMax,也是国内较早做通用大模型的公司之一,文字、图片、视频、语音、音乐它都在做,海螺 AI 就是他家的产品。
M3 的优势说白了就是全能。你同时上传一份报告、几张截图和一段视频,让它整理成调研结论、方案或者 PPT 思路——这种混合材料的任务,它比别家顺手。搜索、办公、代码它也都能干,倍率 0.25。
如果你懒得来回切模型,手上又经常是各种材料混着来,重点考虑它就行。
与其记住所有参数,不如记住”什么活找谁”
Kimi 系列:长文本是它的老本行
Kimi 来自月之暗面,最早就是靠”一次能读很多资料”出圈的,所以在长资料和复杂任务这块,它一直很有辨识度。
Kimi K3 是旗舰款,适合一次处理大量文件做深度研究,或者完成难度比较高的综合任务。它也是整个列表里最贵的,倍率 1.62。我的判断很明确:只有材料真的多到夸张、任务链条特别长,或者便宜模型连续做不好时,才值得选它。日常用这个,积分烧得你心疼,效果还未必比 0.25 那档强多少。
Kimi K2.7 code 是编程专用款,做网站开发、软件修改代码、排查程序问题可以考虑,倍率 0.57。不是开发人员可以直接跳过。Kimi K2.6 更偏日常通用,普通问答、写作、图片和视频理解都能做,倍率 0.52,能力确实比较全面——但要是只盯着性价比看,前面还有更便宜的选择。
DeepSeek V4:写代码这块,它很能打
DeepSeek V4 flash 速度更快、价格更低,适合写代码、改小程序、做数据分析和排查一般的程序问题,倍率 0.17。普通用户偶尔需要做网站、写脚本或者处理点代码任务,先选它。
DeepSeek V4 PRO 更适合大型项目、复杂报错和难度更高的分析,倍率 0.51。我的建议跟上面几个系列一样:先用 flash,flash 明显处理不好再换 PRO,别一上来就上贵的。
实在不想研究?还有两个兜底办法
一是直接用 Auto,让系统根据任务自动选模型,你不用管背后是谁在干活。
二是关于 max 模式——这里很多人误解,它不是最强模型,只是保留更多前文,适合特别长的项目。普通任务不用一直开着,开了反而费积分。
按任务选,别按模型选
记不住参数没关系,把这张对照记住就够了:
写周报、会议纪要、普通文案 → 先 H3;看截图、图表和视频 → 先 GLM 5.3 flash;同时处理文字、图片、视频和长资料 → 选 MiniMax M3;写代码 → 先 DeepSeek V4 flash;材料特别多、任务特别复杂 → 再考虑 HY 4 preview / GLM 5.3 / DeepSeek V4 PRO 或者 Kimi K3。
选对了之后,活儿干得又快又省
我的真实判断:别迷信贵的。大部分人的日常任务,0.05 到 0.25 这一档完全够用,真正需要上 1.62 的场景少之又少。倍率高只代表它更贵、更吃资源,不代表它更适合你手头这个活儿。与其背参数,不如先记住”什么活找谁”——用顺了,你自己就会调。
就测AI www.aijiuce.com